今天和朋友聊天,我们半开玩笑地感叹:“这一周,又是碌碌无为却疲惫不堪的一周。”又累又没收获仿佛是我们生活的日常。
其实,也有一个非常常见的现象:能力越平庸的人,越倾向于在安全区内维护自己“专业且完美”的形象。
OpenAI首席执行官Sam Altman在最新的访问中提到:有些人拥有20年经验,有些人只是把第一年的经验重复了20次。
那我们怎样才能让今天的努力,成为明天能继续使用的能力? 在他的整个访谈中,我总结出四个行动方向,值得我们借用。
Sam Altman谈到,选择尚未获得共识的方向,需要承受短期的尴尬与误解,为长期可能产生的价值投入。
据他回忆,2015年OpenAI成立时,不少人认为这群年轻人在做不切实际的事。ChatGPT早期内部原型约有5%的用户持续使用,其中一些人非常喜欢、频繁使用。他看重这些真实需求,支持尽早发布、获取反馈,也践行了自己常提醒创始人的话:“如果你不为第一版产品感到尴尬,说明你发布得太晚了。”
与其等待完美,不如交付一个有基本用途的初版,用真实反馈找出改进方向。
我们不会每个人都去创业,也不见得都会像Sam Altman一样成功,但可以给自己安排一次48小时初版冲刺:
- 选一件搁置的事。 从那个因为怕评价、怕不够好而迟迟没开始的计划入手。
- 缩小到一个用途。 只解决一个问题,把范围压到48小时内能交付。
- 交给3—5位目标使用者。 观察他们哪里卡住、什么地方有用,以及是否愿意再次使用。
- 让“别人会怎么看我”的猜测,逐渐变成“下一版具体改哪里”的判断,成长就有了可以推进的下一步。
Altman说,自己很少违背所有聪明朋友的意见。信心可以随证据增强,但仍要承认自己可能判断错。
因此,需要同时练习两种能力:提出好问题,以及检查判断的依据。
他对规模效应的关注,就始于观察到神经网络随规模扩大而表现变好,再随着更多证据逐步增强信心。
普通人也可以把目标变成具体、可检验的问题。投入更多资源前,写一张决策校准卡:
- 问题:我在解决谁的什么困难?
- 依据:哪些是事实,哪些只是猜测?
- 检验:下一次尝试,要观察什么结果?
- 调整:出现什么证据,我会改变方法或停止?
提前写下标准,可以避免把“已经投入太多”当成继续的理由。再请一位聪明、严谨、敢说真话的朋友指出逻辑漏洞。对方的认可是一份参考,最终仍要检验实际结果。
把信念放进行动,把判断交给证据。 保持行动,也保留改变主意的能力。
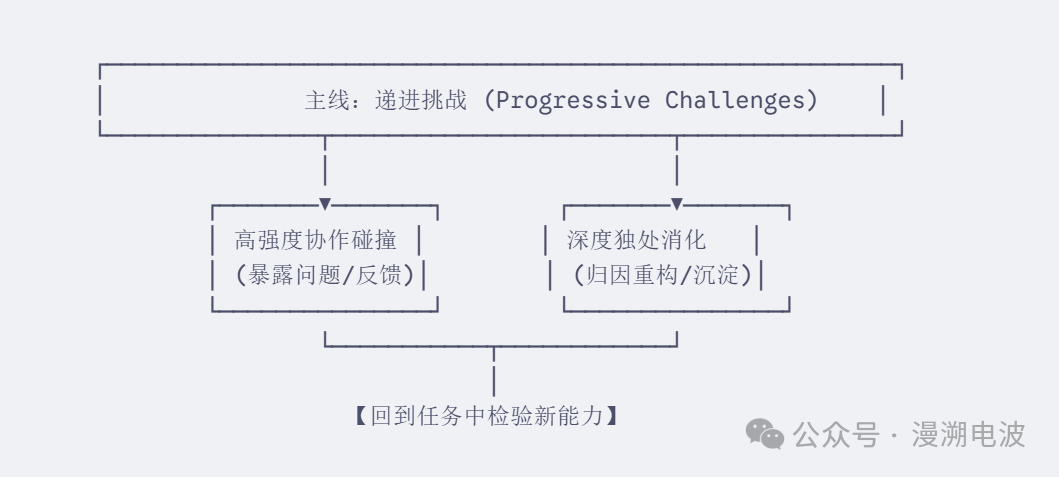
复利是目标,钟摆是支撑。 沿着“挑战—反馈—消化—再尝试”积累能力,用协作与独处的交替,让每轮经历留下具体改进。
- 少听泛泛建议:停止无意义的信息吸食,带着真实任务去执行,在实践中发现问题。
- 阶梯式挑战:能力不是靠凭空想象提升的,而是通过完成难度递增的连续挑战建立起来的。每克服一个稍高难度的关卡,心智与自信就会完成一次复利累加。
- 钟摆式工作节奏:交流时,带着成果听取反馈,发现盲点;独处时,整理意见,明确下一版改什么、为什么改;再回到任务中,检验改动是否有效、适用于什么条件。
让每轮工作都留下一个更准确的判断、一项新能力,或一种改进的方法。这样,下一次开始时,你就有了更高的起点。
Altman在访谈中讲到自己听说的一个例子:一位没有筹款经验的印度学生,借助AI工具完成了学校筹款的多个环节。工具的价值,在于降低门槛,让一个原本缺少经验的人也能行动起来。
成就他人,可以从降低行动门槛开始。 把自己习以为常的判断,整理成别人看得懂、用得上的方法。比如,将“项目需求要提前问清楚”,细化成一份包含关键问题、常见误区和填写示例的清单。再请一位目标使用者独立尝试,观察:
- 他能否完成任务?
- 哪一步仍然需要额外解释?
- 这份方法是否减少了试错,帮助他作出更好的判断?
根据实际使用继续改进。对方获得解决问题的能力,你获得真实反馈,也有机会积累信任与合作关系。这种共同收益,需要靠持续有效的交付来延续。
让别人因为你的积累少走弯路,也让你的价值,在一次次被需要、被信任中留下来。
别再用体力的消耗去掩盖战略的懒惰,也别把岁月的叠加当成能力的沉淀。从“允许尴尬”的心智破局,到“基于规律”的决策校准,再到“钟摆交替”的能力递进,这套系统随时可以嵌入你当下的生活。
你未来的高度,不取决于你听过多少道理,而取决于你敢不敢推翻旧惯性,为自己重构一套能够自我迭代的底层代码。
https://mp.weixin.qq.com/s/1JsmPr58K8qZUHT16u5VBQ